
Návody a postupy - Excel, on-line neparametrické testy
Neparametrické testy
Vybrané neparametrické testy
Tyto testy s výjimkou testů na shodu binomického rozložení a χ2 testu nejsou součástí statistických funkcí a Analýzy dat tabulkového kalkulátoru Excel. Jsou však volně dostupné na internetu v řadě různých verzích. Pro účely tohoto základního kurzu biostatististiky jsme vybrali webovské stránky Vassar College, Poughkeepsie, NY, USA, které najdete na:
Poznámka: Používáte-li jako webovský prohlížeč MS InternetExplorer v. 7 a vyšší je pro správné fungování programu mít server faculty.vassar.edu uvedený mezi důvěryhodnými servery (Nástroje→Možnosti Internetu→Zabezpečení). Jestliže tam není uveden a nechcete nastavení měnit, můžete použít např. prohlížeč Mozzila Firefox.
Upozornění: v případě, že data obsahují desetinná místa, je nutné jako oddělovač desetinnou tečku!
Úvodní stránka, která se objeví, uvádí přehled částí statistiky, ke kterým jsou uvedeny příslušné výpočty
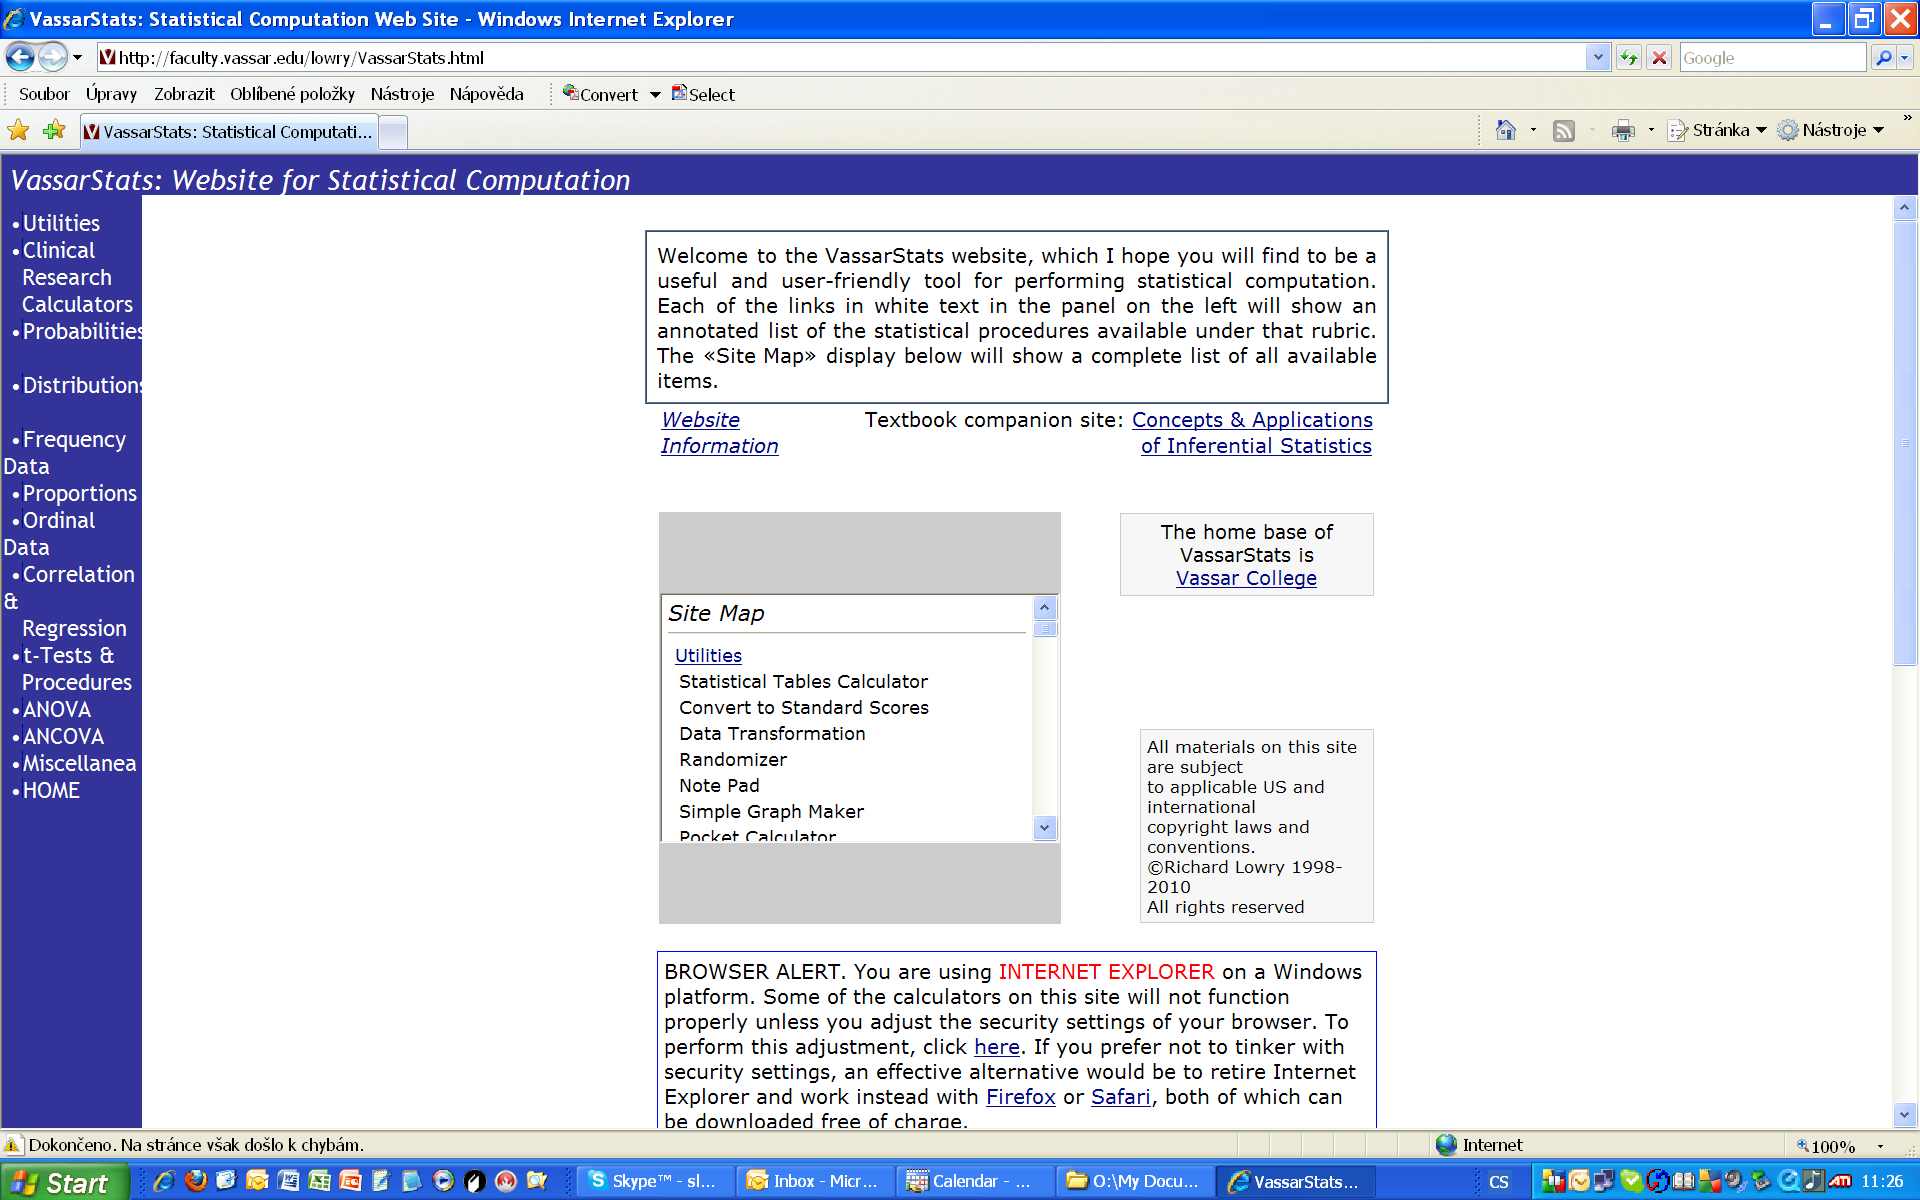
Z nabídnutých možností nás v dalším výkladu budou zajímat oddíly označené jako Frequency Data, Proportions a Ordinal Data. Po kliknutí na Frequency Data se objeví
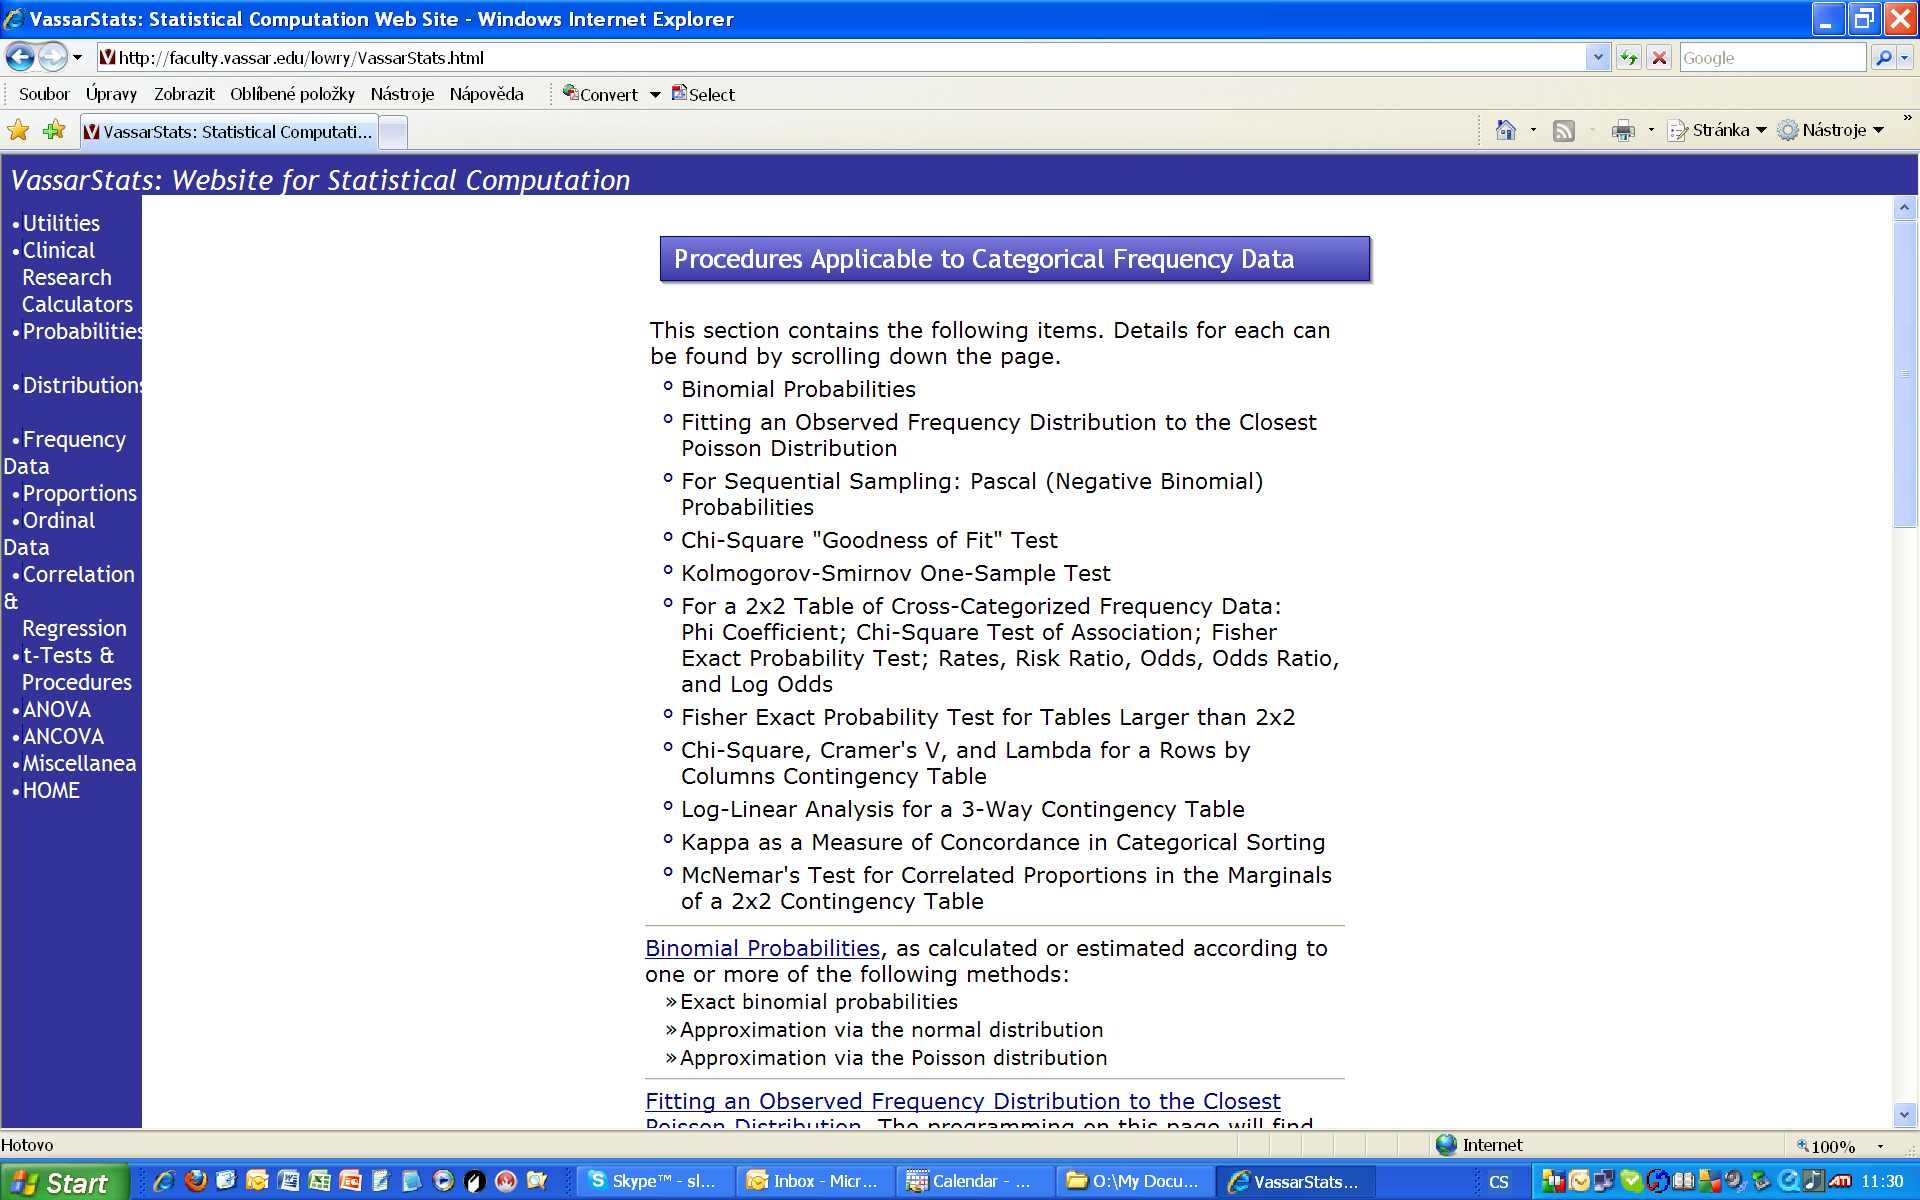
Nejdříve si ukážeme jak počítat znaménkový test. K tomu se dostaneme klinutím na Binomial Probabilities. Spočítáme p hodnotu pro příklad uvedený v části 7 knihy Induktivní statistika. V tabulce jsou uvedeny doby potřebné k řešení určitého typu příkladů před specializovaným cvičením a po něm:
Před cvič. (s) 87 61 98 90 93 74 83 72 81 75 83
Po cvič. (s) 50 45 79 90 88 65 52 79 84 61 52
Znaménkem plus označíme ty hodnoty, kdy se po cvičení doba k řešení příkladu zkrátila, znaménkem mínus ty případy, kdy naopak doba potřebná k řešení příkladu byla delší. Pokud je diference v dobách řešení nulová, jde o tzv. svázané hodnoty (ties) a o ně počet analyzovaných údajů snížíme. V tomto příkladu to je výsledek jednoho studenta (v obou případech dosáhl 90 bodů), takže celkový počet analyzovaných dat se sníží na deset párů a počet úspěchů je 8.
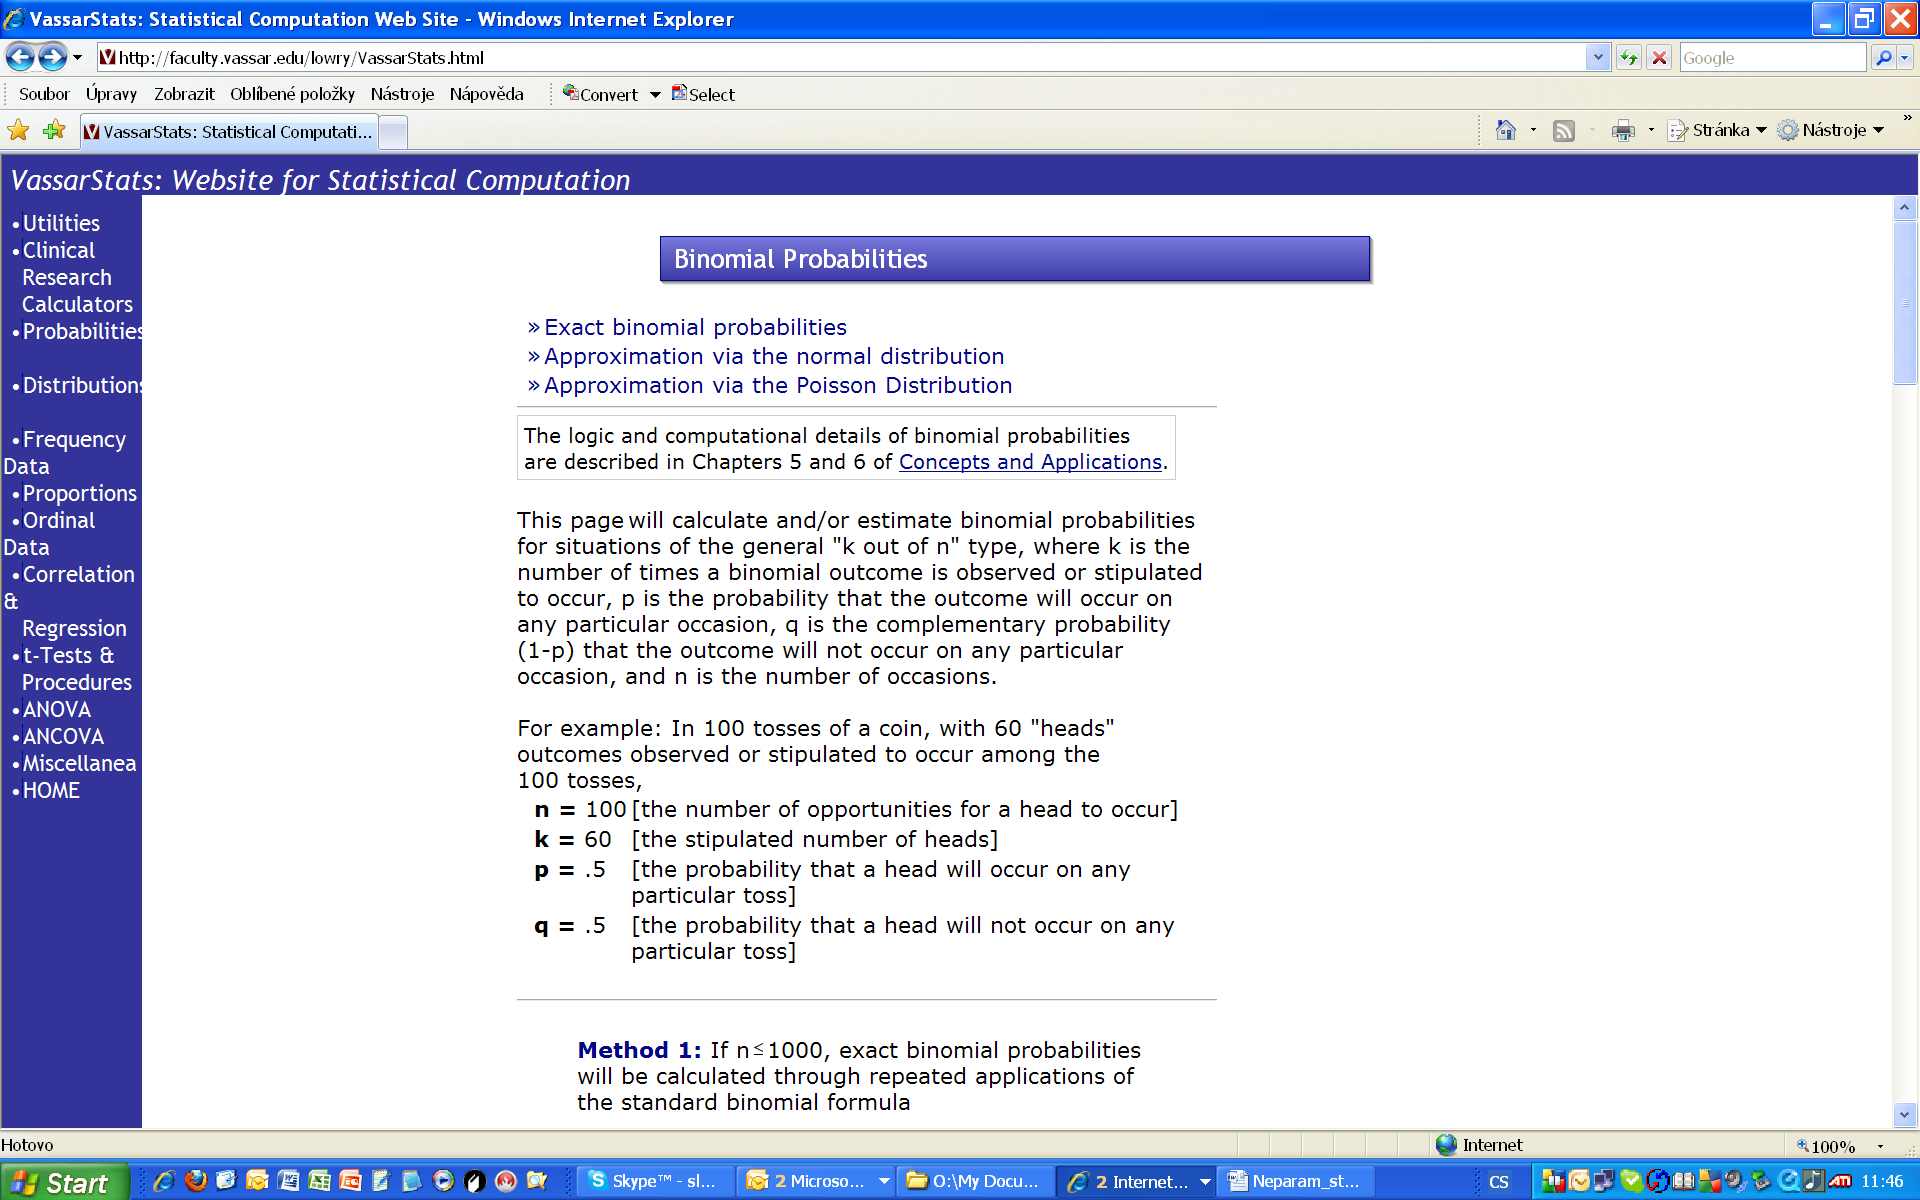
Pro další výpočet n = 9 (celkový počet, zmenšený o svázané hodnoty), k = 8 (počet kratších dob) a p = 0.5. Posuneme se do části, kde tabulka pro vložení vstupních údajů:
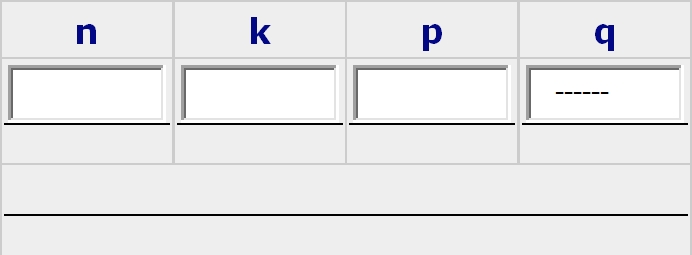
Zapíšeme uvedené hodnoty a klikneme na Calculate
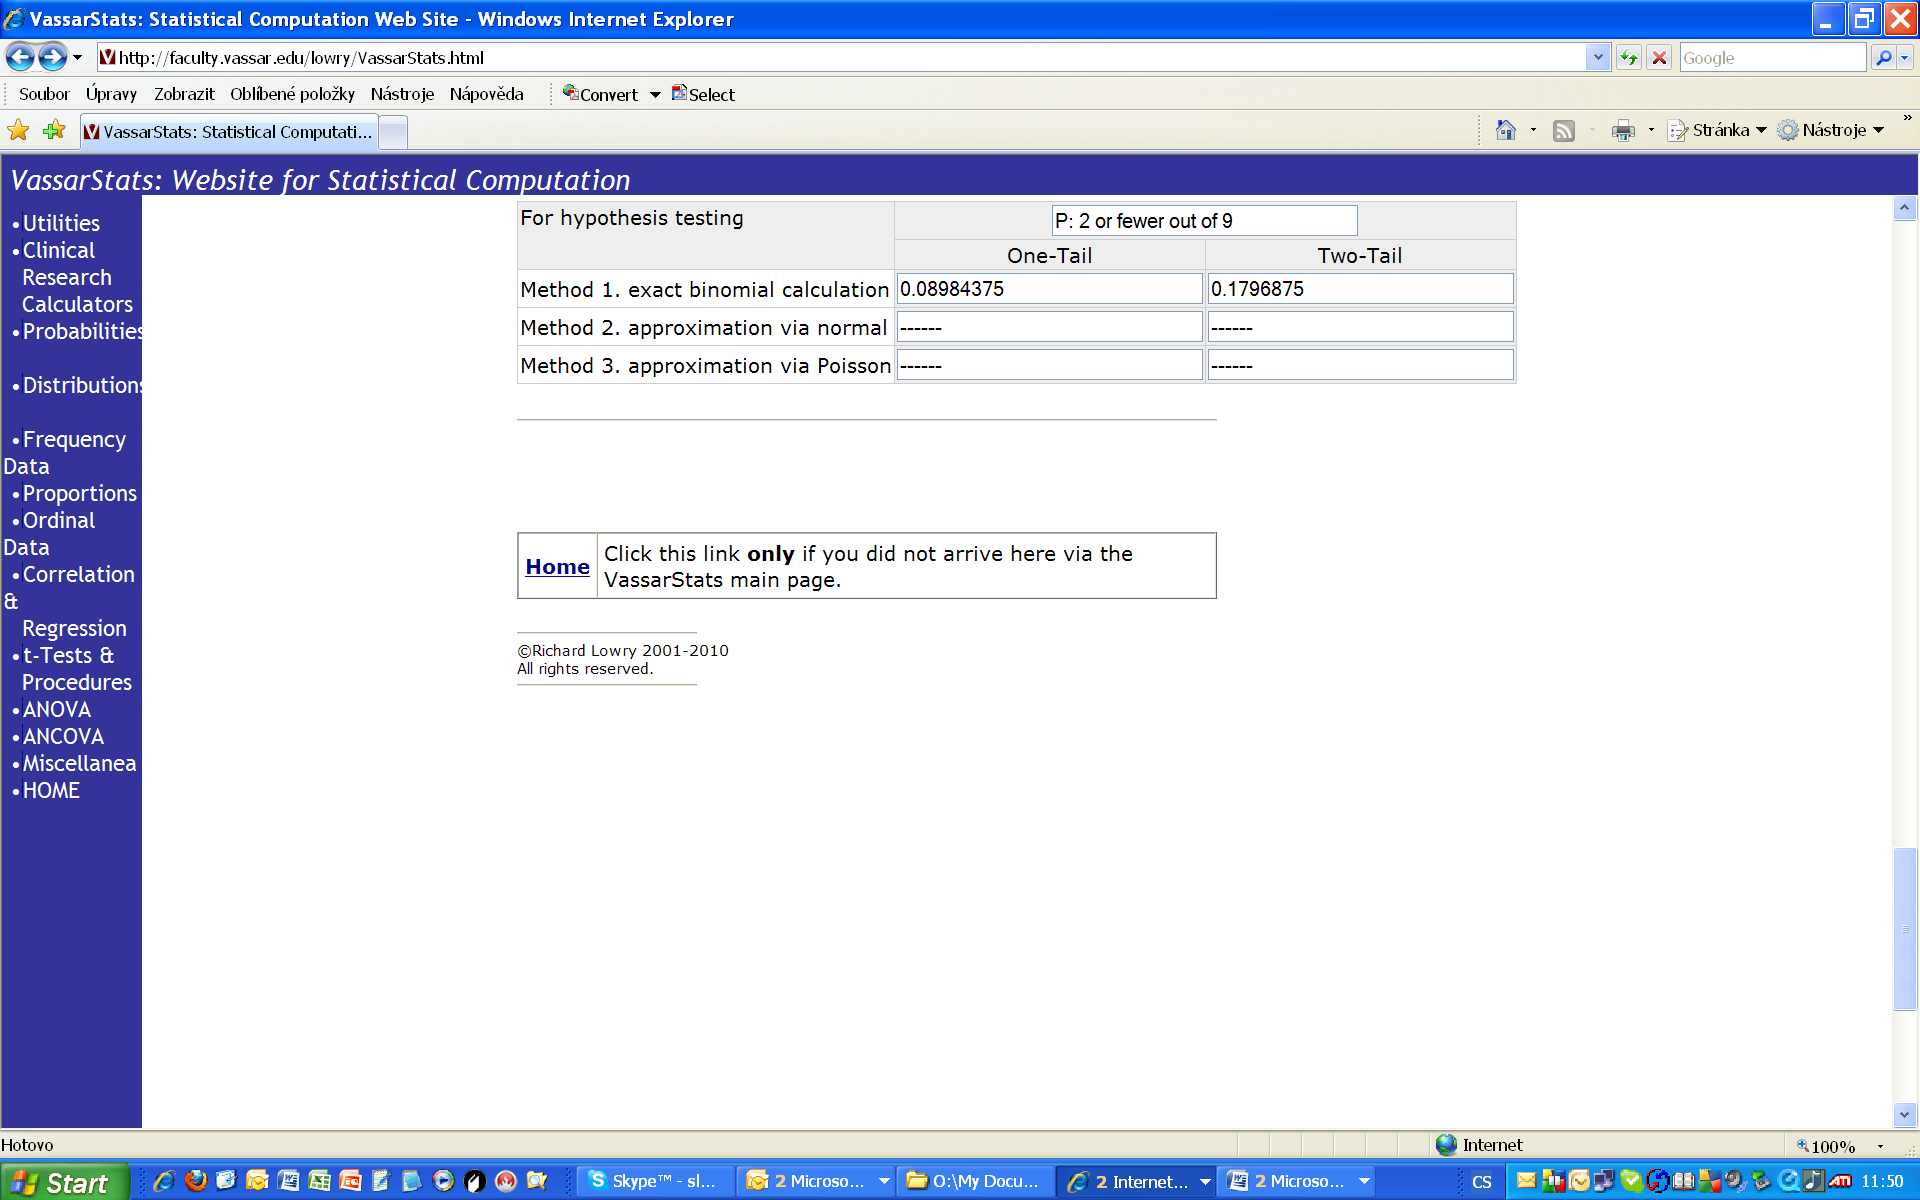
Výsledek (hledané p) je v řádku na konci tohoto okna, označeném Method1. exact binomial calculation, v buňce pod One-Tail (p hodnota jednostranné alternativní hypotézy a je rovné 0,0898.
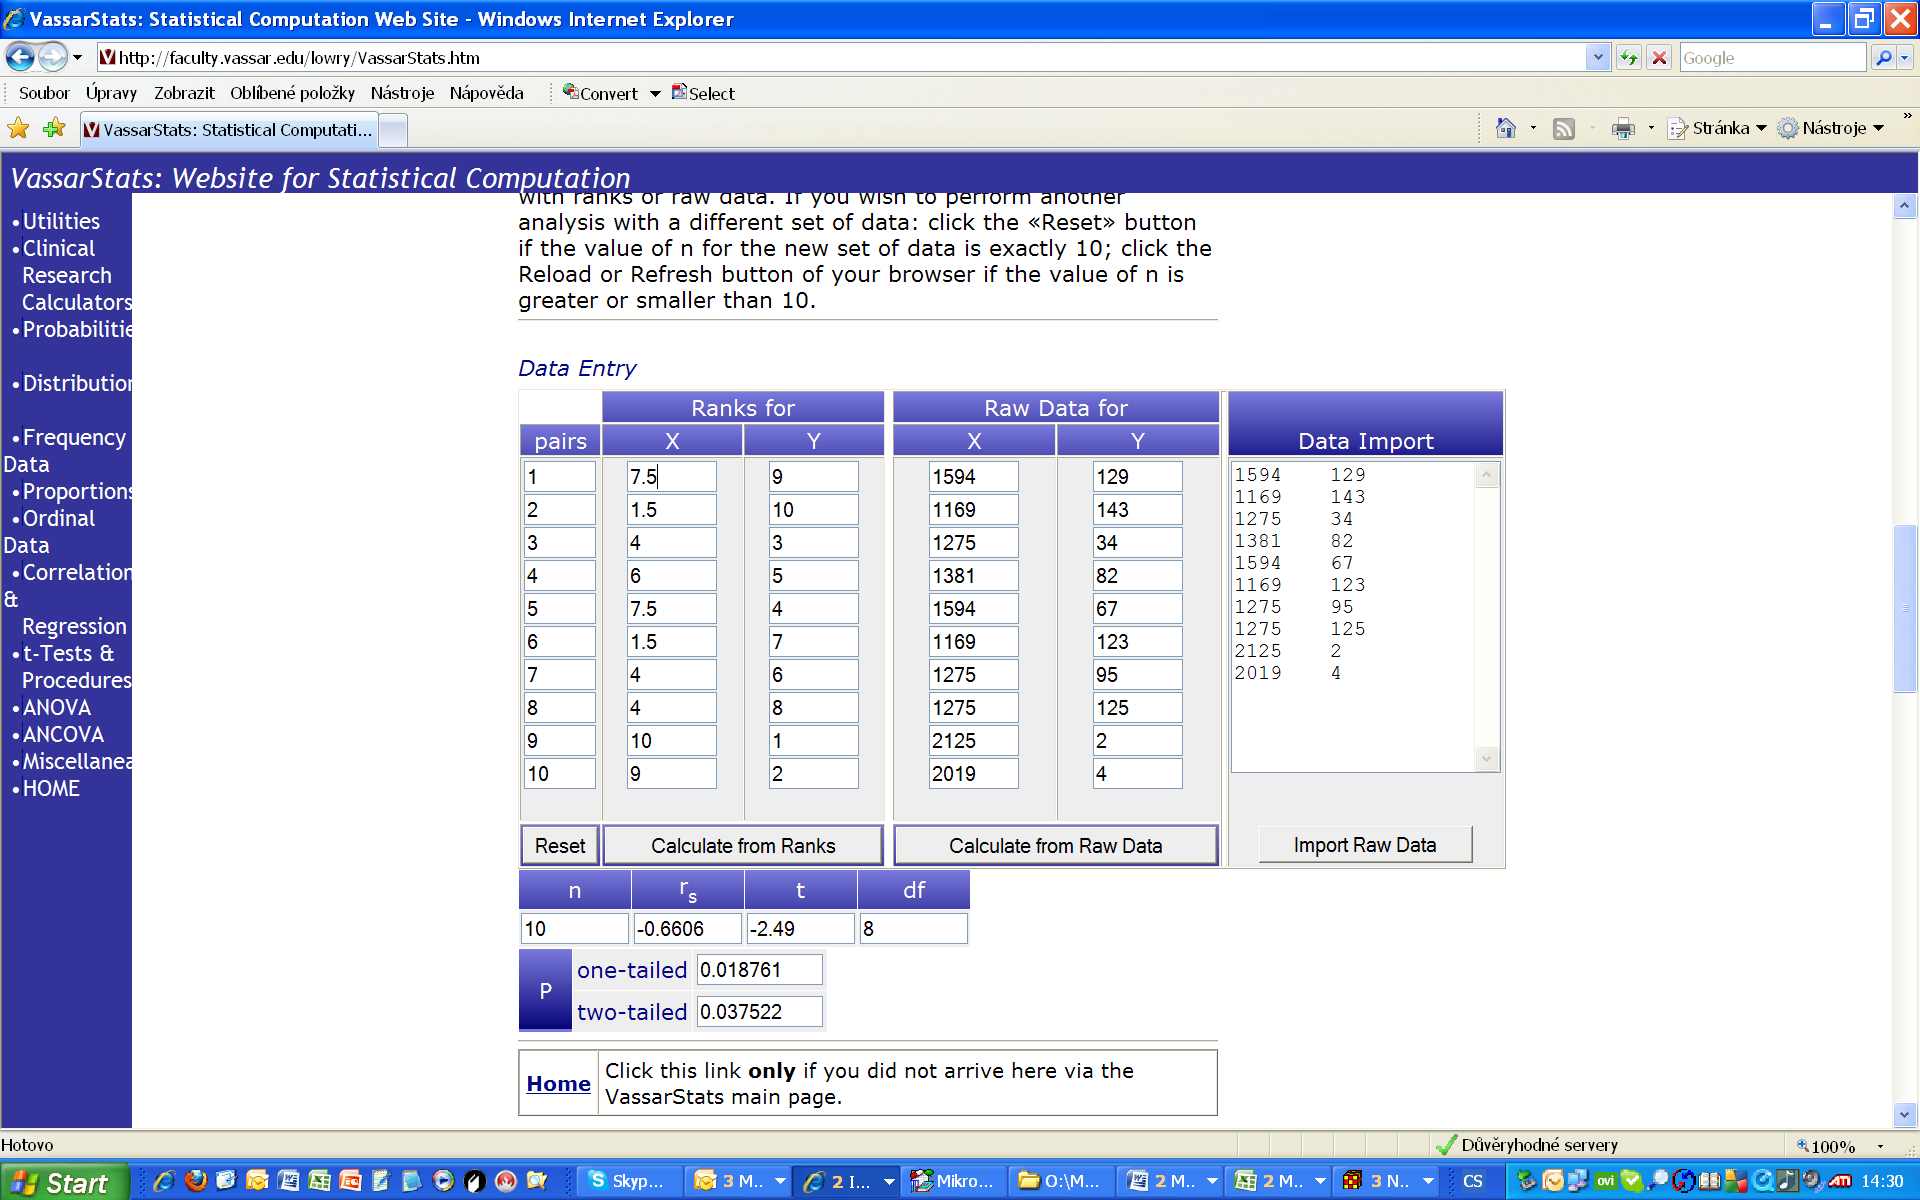
Spearmanův koeficient pořadové korelace vypočítáme kliknutím na Correlation & Regression®Rank Order Correlation, do okna Please enter the value of n, zadáme pro uvedený příklad 10 a do části Data Entry vložíme pomocí Ctrl V dva sloupce vstupních dat (bez hlavičky). Vymažeme kursor v posledním (prázdném řádku, takže bliká za poslední hodnotou druhého sloupce (4). V dalším kroku klikneme na Calculate from Raw Data a do sloupců Ranks for se dopočítají odpovídající pořadí a v buňce označené rS je hodnota Spearmanova pořadového koeficientu korelace (−.6606) a v buňce two-tailed je p hodnota oboustranné alternativní hypotézy (0,035722).
Dalším pořadovým testem je Mannův-Whitneyův U test, který spočítáme kliknutím na Ordinal Data®Mann-Whitney Test. Jako příklad uvedeme výpočet p hodnoty pro zjištění účinnosti nového analgetika vevedený v kapitole Induktivní statistika, část 7. Některé neparametrické testy, oddíl Pořadové testy.
Placebo 20 5 2 7,5 2 13 15,5 10 5 10 13
Lék 20 20 15,5 17 13 10 5 2 7,5 18
Jako první musíme zadat Počet prvků v jedné skupině (A) 11, a potom počet prvků v druhé skupině (B) 10. Není-li n v obou skupinách stejné, zadáme data ze skupiny s větším počtem prvků jako první. Do části Data Entry Sample A vložíme pomocí Ctrl V sloupec vstupních dat pro Placebo (bez hlavičky), vymažeme kursor v posledním (prázdném řádku, takže bliká za poslední hodnotou(13).
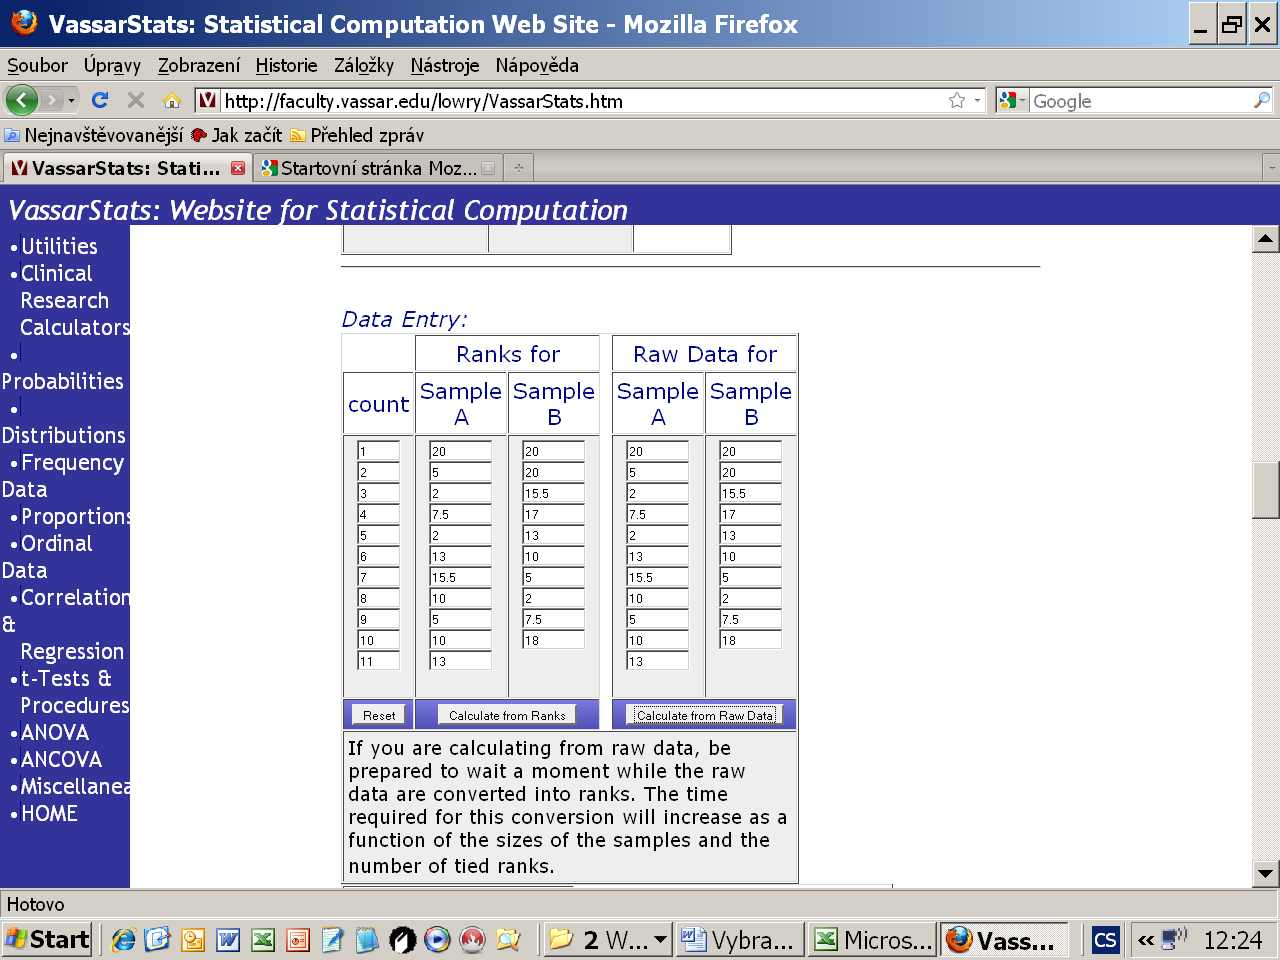
Totéž provedeme pro data z řádku Lék. Pak klikneme na Import data to data cells a Calculate from Raw Data a do sloupců Ranks for se dopočítají hodnoty odpovídající společnému pořadí z obou skupin.
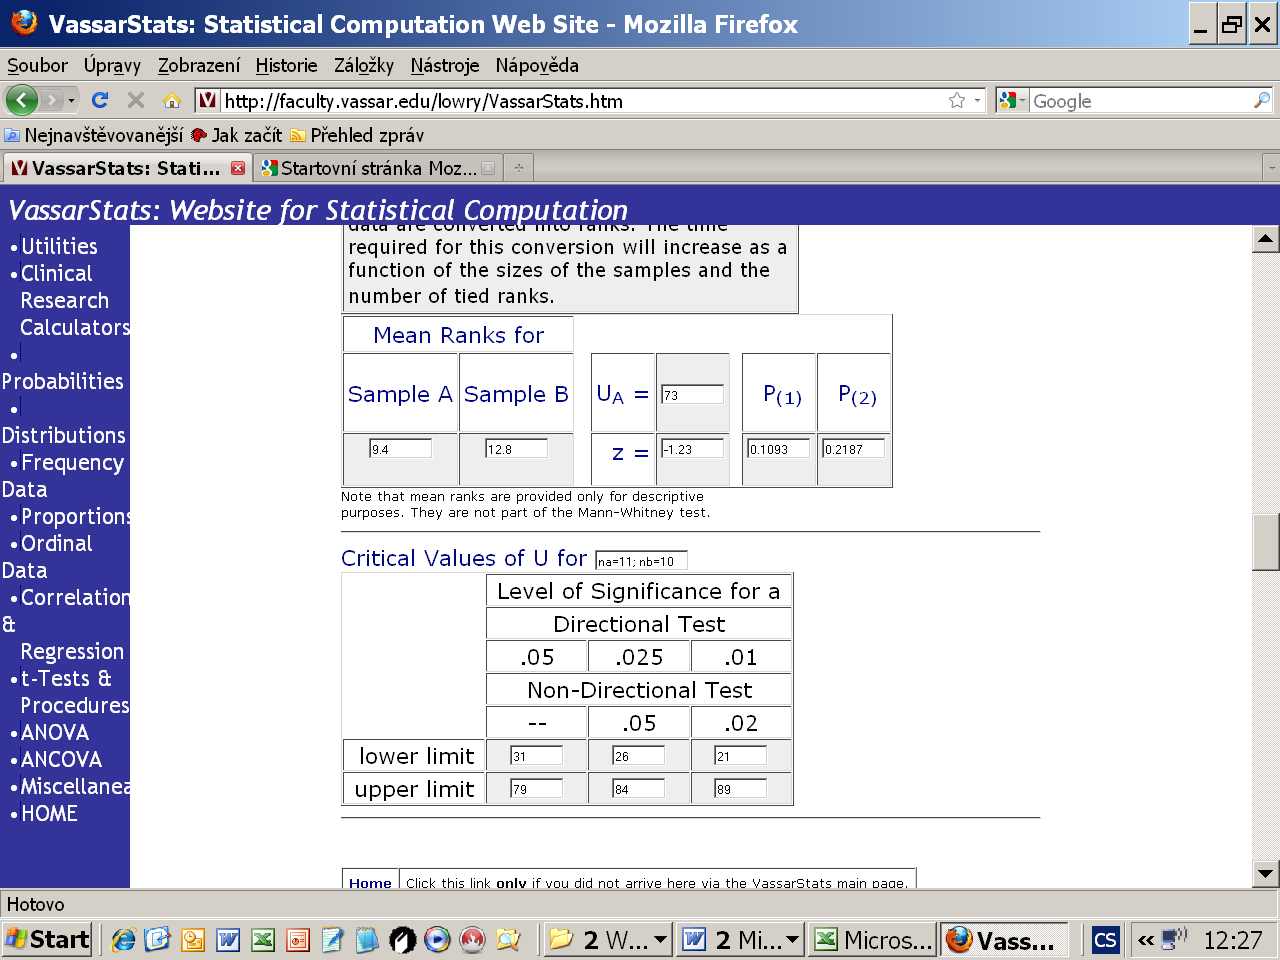
V další části je hodnota testového kritéria UA (73) p hodnota jednostranné alternativní hypotézy pro aproximaci Gaussovým rozdělením (z skór -1,23) 0,1093. Nezamítáme tedy nulovou hypotézu a neprokázali jsme statisticky významnou účinnost nového analgetika.
χ2 test
K zjištění názorů studentů, kteří zažili starý studijní řád i nově zavedený kreditní systém bylo jich náhodně vybráno 80 (34 mužů, 46 dívek, což odpovídá poměru zastoupení pohlaví na fakultě). Dvanáct studentů uvedlo, že si myslí, že jim kreditní systém více vyhovuje, u dívek mělo stejný názor 36.
Z webovské stránky vybereme Frequency Data→Version 1 (For a 2×2 Table of Cross-Categorized Frequency Data) do tabulky Data Entry zapíšeme zjištěné četnosti
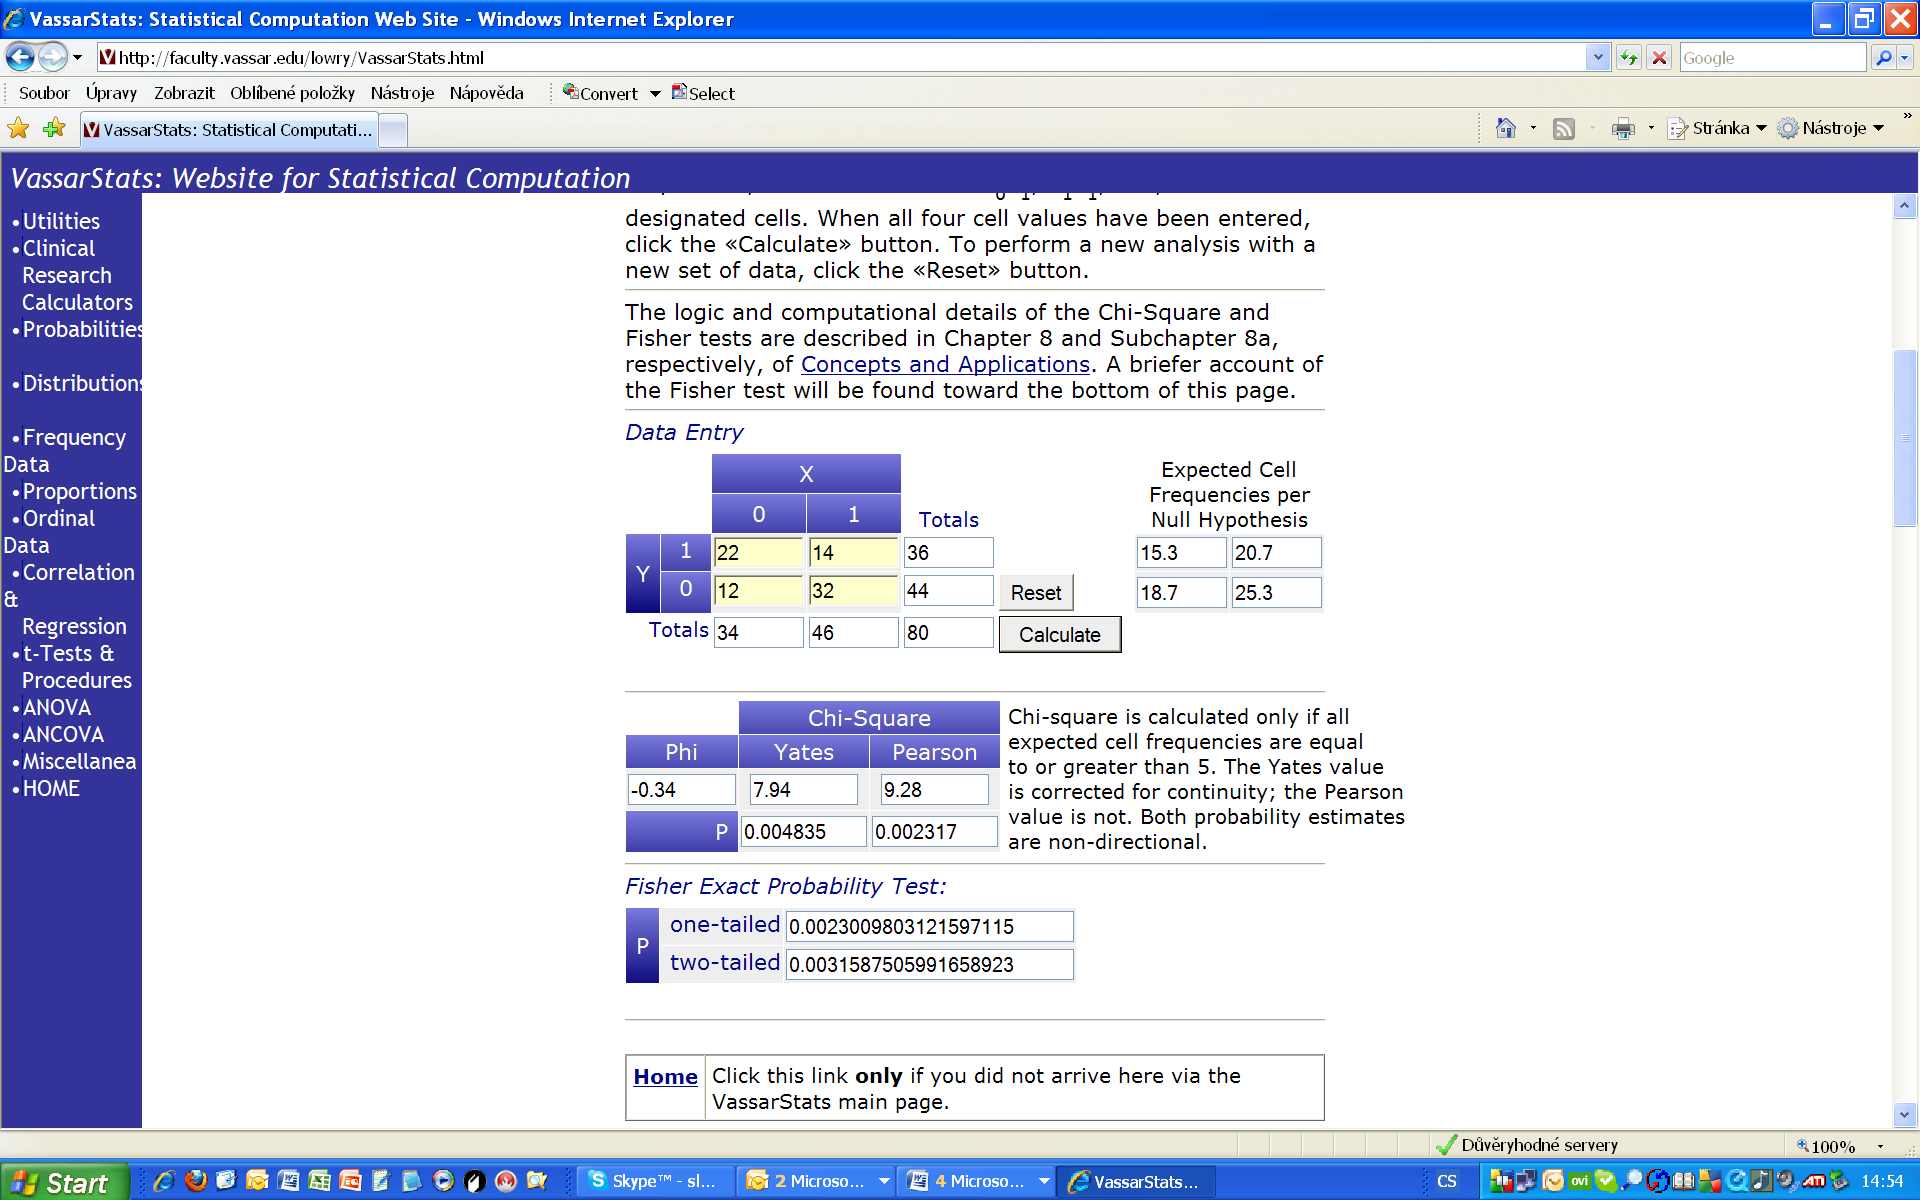
X = 0 – muži, 1 – ženy, Y = 1 – pro kreditní systém, 0 – pro původní systém.
Hodnoty testových kritérií jsou 9, 28 v případě klasického χ2 testu (p hodnota pro oboustrannou alternativní hypotézu je 0,00232) a pro Yatesovu korekci 7,94 (p hodnota pro oboustrannou alternativní hypotézu je 0,00484). Dále jsou uvedeny výsledky Fisherova přesného testu s p hodnotou pro oboustrannou alternativní hypotézu 0,00316 a pro jednostrannou alternativní hypotézu se p rovná 0,002230. Na základě p hodnot obou variant χ×2 testu i Fisherova přesného testu zamítáme nulovou hypotézu a prohlásíme, že hodnocení dvou variant studijního systém souvisí s pohlavím respondentů.
Po doplnění předešlého průzkumu o 15 jedinců, kteří se nemohli rozhodnout o výhodnosti žádného z obou systémů se z tabulky 2×2 stane tabulka 2×3. V té můžeme závislost testovat χ2 testem v činnosti Frequency Data→Chi-Square, Cramer's V, and Lambda. Nejprve zadáme počet řádků, pak počet sloupců.
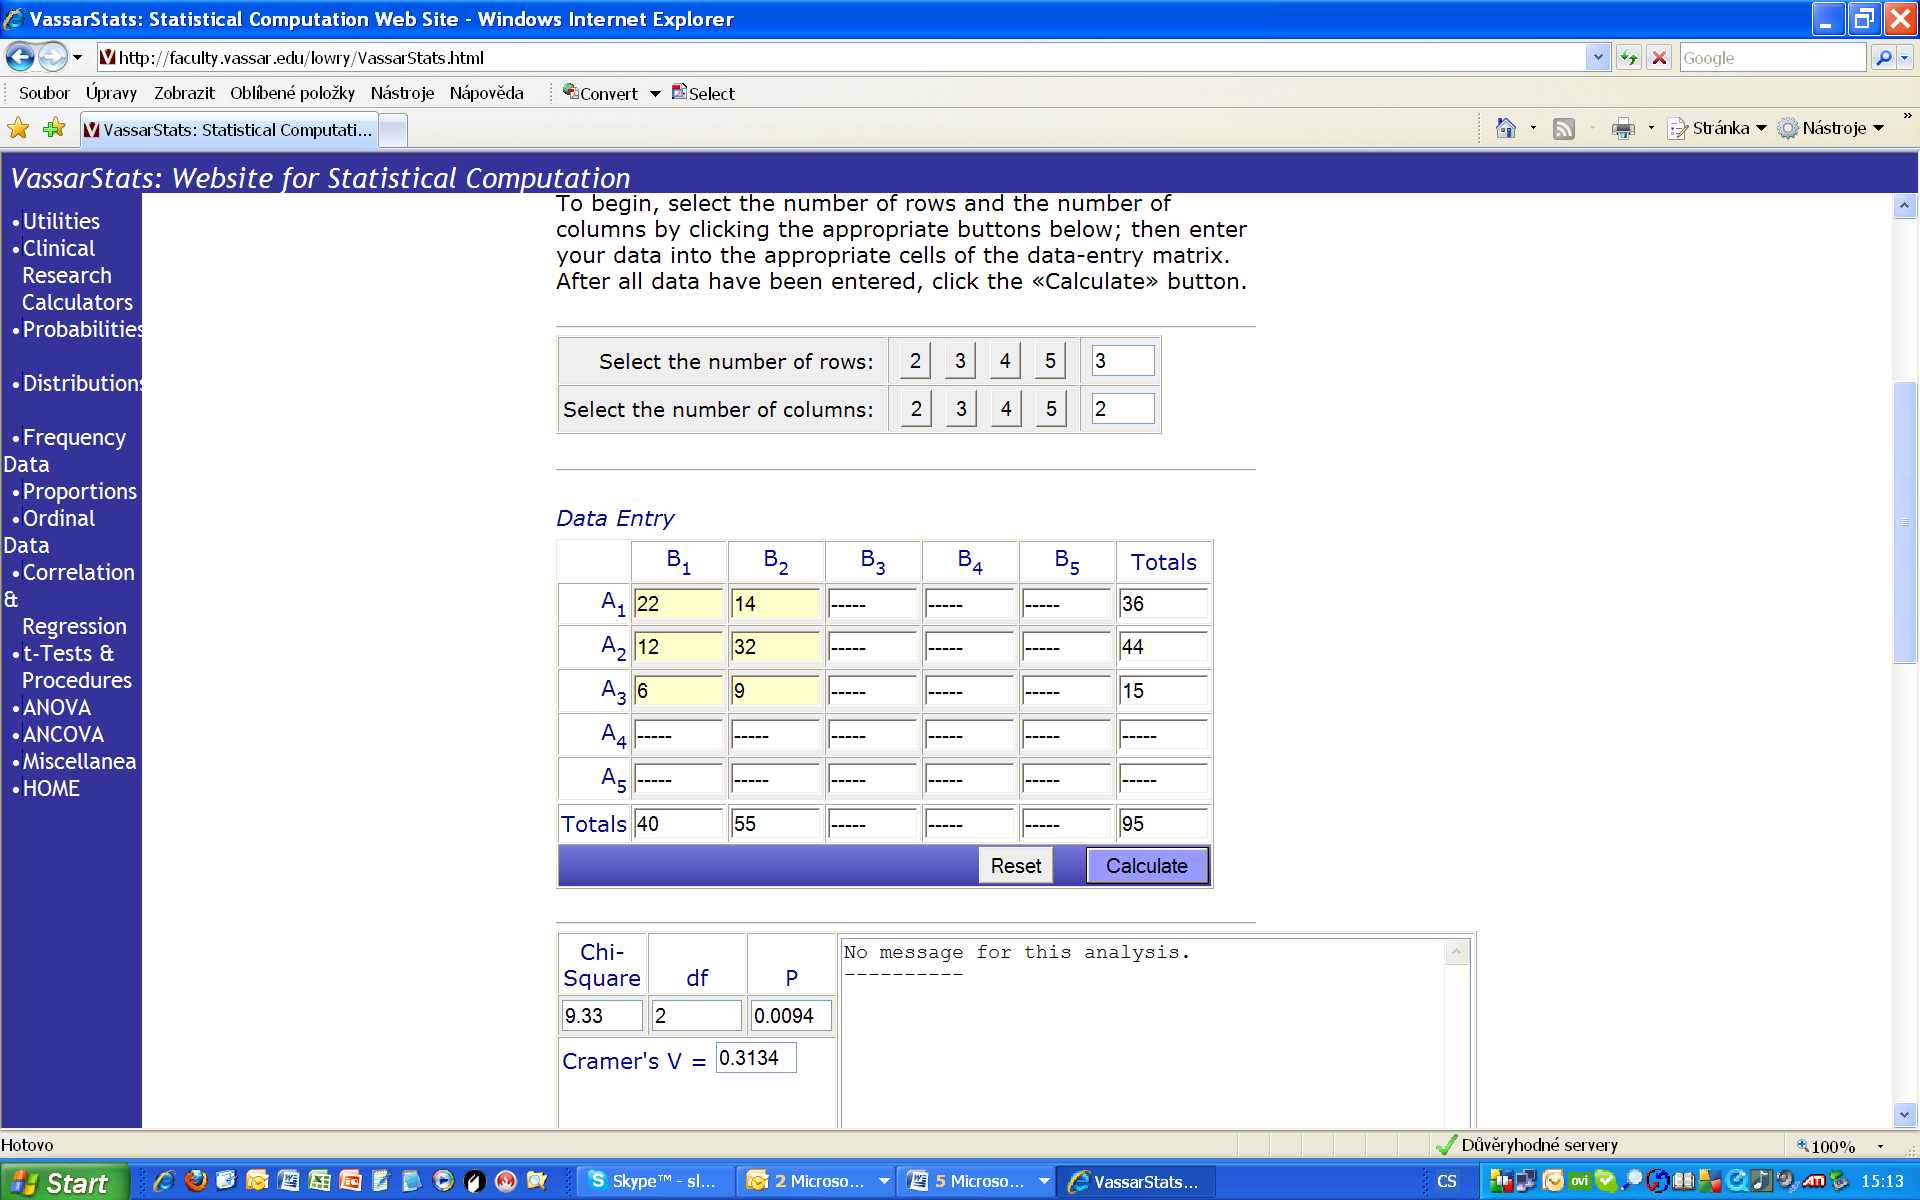
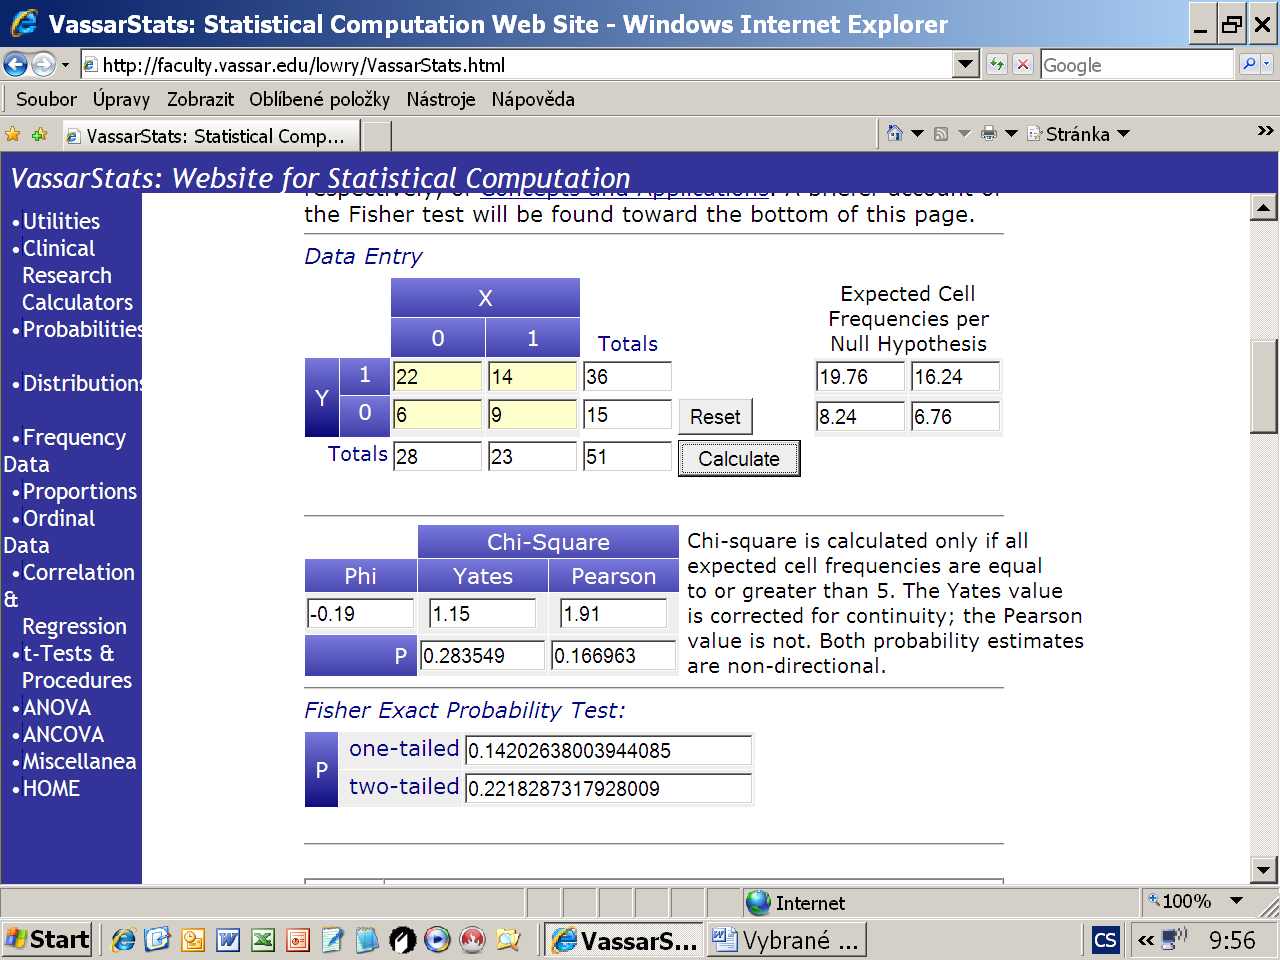
Počet stupňů volnosti jsou 2, testové kritérium 9,33 a p hodnota 0,0094. Můžeme tedy zamítnout nulovou hypotézu a prohlásit, že existuje vztah mezi pohlavím a hodnocením použitého studijního systému, nevíme však, jak to je se závislostí mezi jednotlivými řádky vícepólové tabulky. To ověříme použitím stejného testu jako v předcházejícím příkladu. Při srovnání prvního a třetího řádku jsou p hodnoty pro Yatesovu korekci, klasický χ2 test a Fisherův přesný test 0,284, 0167 a 0,222.
Srovnáním druhého a třetího řádku zjistíme p hodnotu Fisherova testu rovnou 0,517 (χ2 test se nespočítal, protože očekávaná četnost v buňce X = 0 a Y = 0 je menší než požadovaných 5). Nezamítáme nulovou hypotézu a prohlásíme, že se nepodařilo prokázat kladný ani záporný vztah k systému studia a pohlavím u nerozhodnutých studentů.
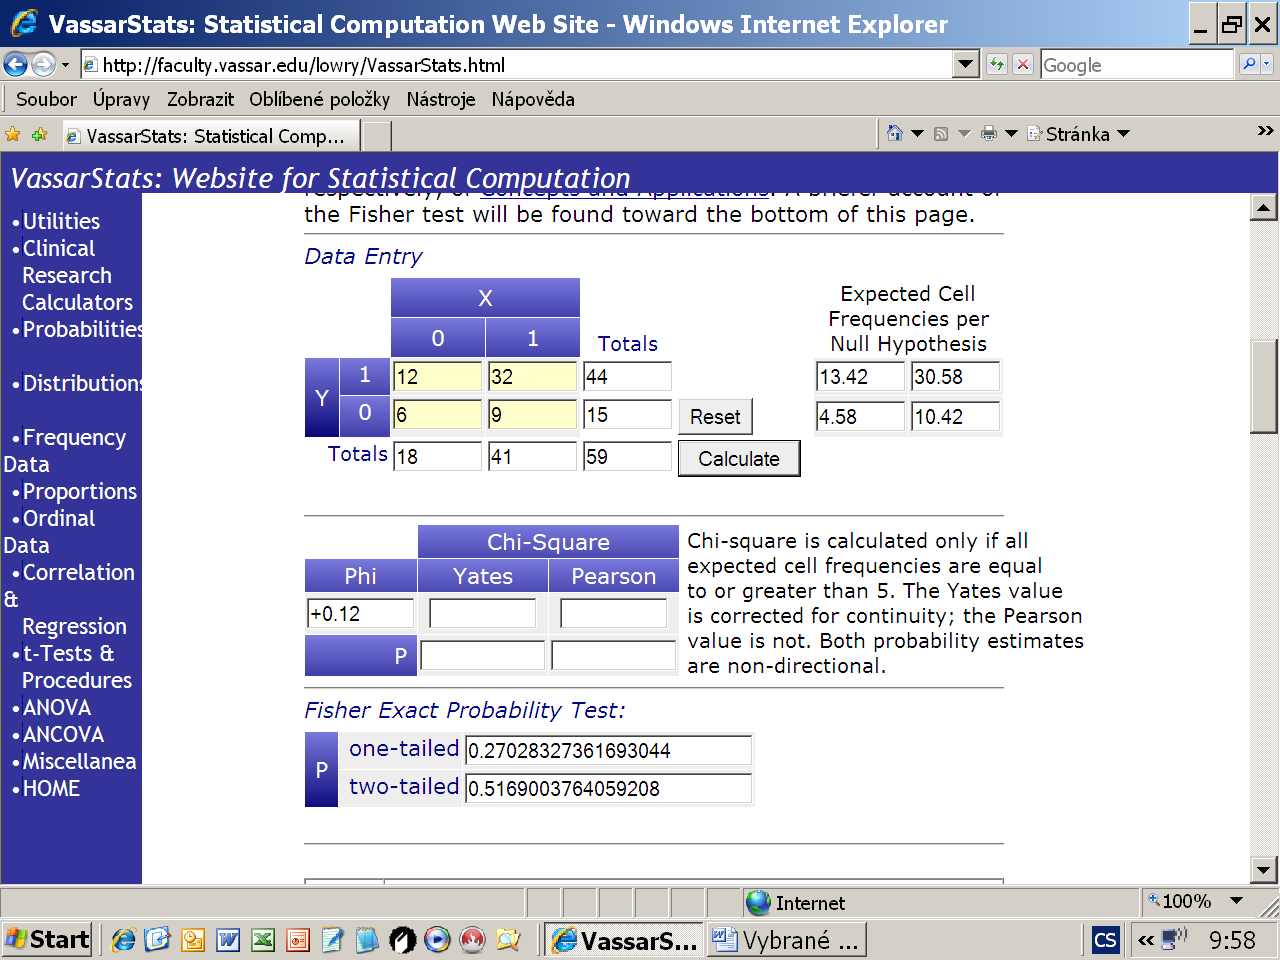
Koeficient Phi je pro tabulky 2×2 post hoc testem odhadujícím sílu vztahu mezi testovanými veličinami a Cramerovo V má stejný význam pro tabulky větší.